robots.txtの書き方|noindexとの違い・設定例・確認手順
2026年4月25日
著者: 与謝秀作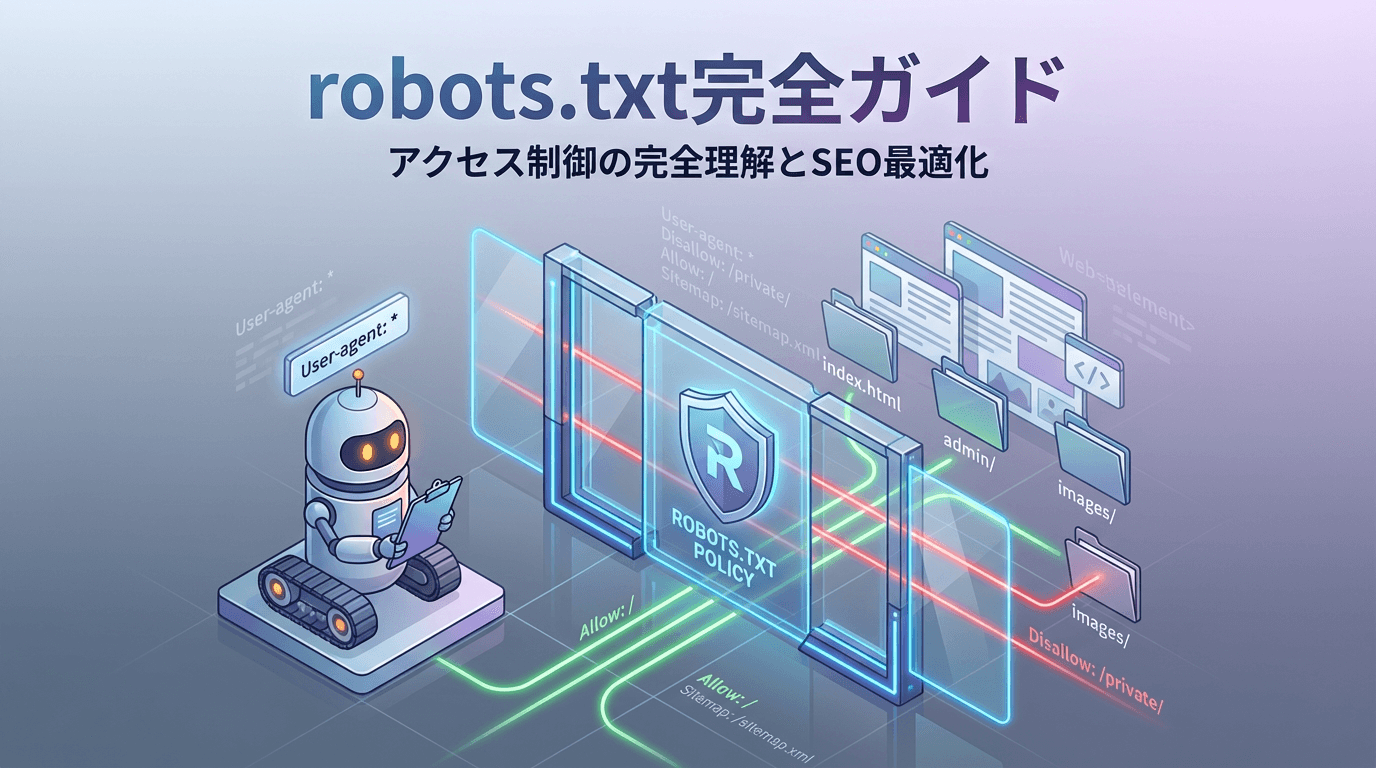
robots.txtは、対応するクローラーに対して取得を許可・制限するパスを伝えるファイルです。検索結果から確実に消すための設定でも、秘密情報を守るアクセス制御でもありません。目的が「検索表示を止める」のか「取得を減らす」のか「第三者に見せない」のかで、使う手段を分けます。
Googleのrobots.txtの説明も、クロール制御とインデックス制御を区別しています。DisallowしたURLが他ページから発見され、内容を取得せず検索結果に現れる場合がある点に注意してください。
目的別に設定を選ぶ
目的 | 検討する手段 | 注意点 |
|---|---|---|
不要なパスの取得を制御 | robots.txt | 検索登録を直接禁止するものではない |
公開ページを検索結果に出さない | noindex | クローラーが指示を読める必要がある |
会員専用・社内情報を保護 | 認証・アクセス制御 | robots.txtだけでは保護できない |
重複URLの代表を伝える | 正規化・canonical等 | robots.txtの代替用途とは分ける |
緊急に検索表示を一時的に隠す | Search Consoleの削除機能等 | 恒久対応を別途検討する |
noindexを追加したページを同時にDisallowすると、クローラーがnoindexを読めなくなる場合があります。公開・非公開の設計は、指示が届く順序も含めて考えます。
ファイルの場所と基本構文
robots.txtは対象のホストのルートに置きます。例えばhttps://example.com/robots.txtです。別ホストや別のプロトコル・ポートについては適用範囲を個別に確認します。サイト内の適当なフォルダに置いても、同じように認識されるわけではありません。
次は説明用の設定です。そのまま本番へ貼り付けず、実際のURL構造に合わせて検証してください。
User-agent: *
Disallow: /private/
Allow: /private/help/Sitemap: https://example.com/sitemap.xml
テストするURLのパス | 上記ルールでの意図 |
|---|---|
/products/chair | 制限対象にしない |
/private/report | 取得を制限する |
/private/help/start | より具体的なAllowで取得を許可する |
/Private/report | 大文字・小文字が違うため、同じパスとは扱わない |
User-agentは対象クローラー、Disallowは制限するパス、Allowは許可するパス、Sitemapはサイトマップの場所を示します。細かいルールの解釈や対応範囲はクローラーによって異なります。Google向けの設計を別サービスへそのまま当てはめないでください。
事故につながりやすい設定
Disallow: /を本番へ持ち込む:広い範囲の取得を妨げる。- 表示に必要なCSSやJavaScriptを制限する:検索エンジンによるページ理解に影響する可能性がある。
- 機密パスを列挙すれば安全と考える:ファイル自体は公開され、アクセスを防げない。
- noindexの代わりに使う:既存の検索表示が一定日数で消えるとは保証できない。
- 競合するグループを追加し続ける:対象クローラーに適用されるルールを把握しにくくする。
まず現在のファイルと変更理由を保存し、必要な差分だけを作ります。大量のURLを一括で制限する前に、公開記事、画像、カテゴリ、検索結果ページなど代表パターンをテスト表にします。
変更前後の確認と切り戻し
段階 | 点検内容 | 記録するもの |
|---|---|---|
変更前 | 現行ファイル、対象パス、意図した結果 | バックアップ・責任者・変更日時 |
検証 | 代表URLが許可/制限されるか | URL・想定・確認結果 |
反映後 | ファイル取得、内容、検索管理ツールの状態 | HTTP状態とレポートの結果 |
経過確認 | クロール・登録状況に想定外の変化がないか | 変更前後の比較と他の変更 |
切り戻し | 問題のある差分を戻す | 判断者、復元した版、再確認結果 |
Search Consoleでは現行のrobots.txtレポートやURL検査を使って状態を確認します。過去にあったクロール頻度設定ツールは2024年1月8日に終了しており、現在の対策として案内すべきものではありません。反映や再取得には時間がかかることがあるため、保存直後の一つの結果だけで全URLの状態を断定しません。
AIクローラーも用途を分けて確認する
検索用、学習用、利用者の操作に応じて取得するものなど、同じ企業でも複数のクローラーや取得方法があります。特定のAIサービスへの対応が必要な場合は、その事業者が公表するUser-agentと用途、robots.txtへの対応範囲を確認します。名前が似ているから一つの指示ですべてを制御できるとは限りません。
robots.txtの変更は、記事の内容改善とは別の技術作業です。問題があるURLについて、取得制限、noindex、正規URL、応答状態を順に確認し、原因に合う手段を選びましょう。
関連するガイド
数値を継続して振り返る
広告データの集約・比較・レポート作成を継続したい場合は、NeX-Rayの対応媒体と機能を確認できます。必要な分析機能とプランを確認して、無料で始めるから試してください。
出典・確認先
媒体仕様・公開資料は2026年10月1日に確認しました。利用できる機能や画面はアカウント・地域で異なる場合があるため、設定前に公式案内を確認してください。